情報確認日:2026年11月3日。ソフトウェアの対応環境や価格は変わることがあります。
結論:フィジカルAIは、カメラやセンサーで周りの状況をとらえ、ロボットなどの体を動かして現実の世界で働く AI です。文章や画像を返す生成AIと違って、出力はモーターへの指令です。歩き方のような体の動かし方は、シミュレーションの中でたくさんのロボットに試行錯誤させる強化学習で身につけさせ、その結果を実機に移します(sim-to-real)。机の上に置ける二足歩行ロボットなら、この流れを手元で一通り試せます。
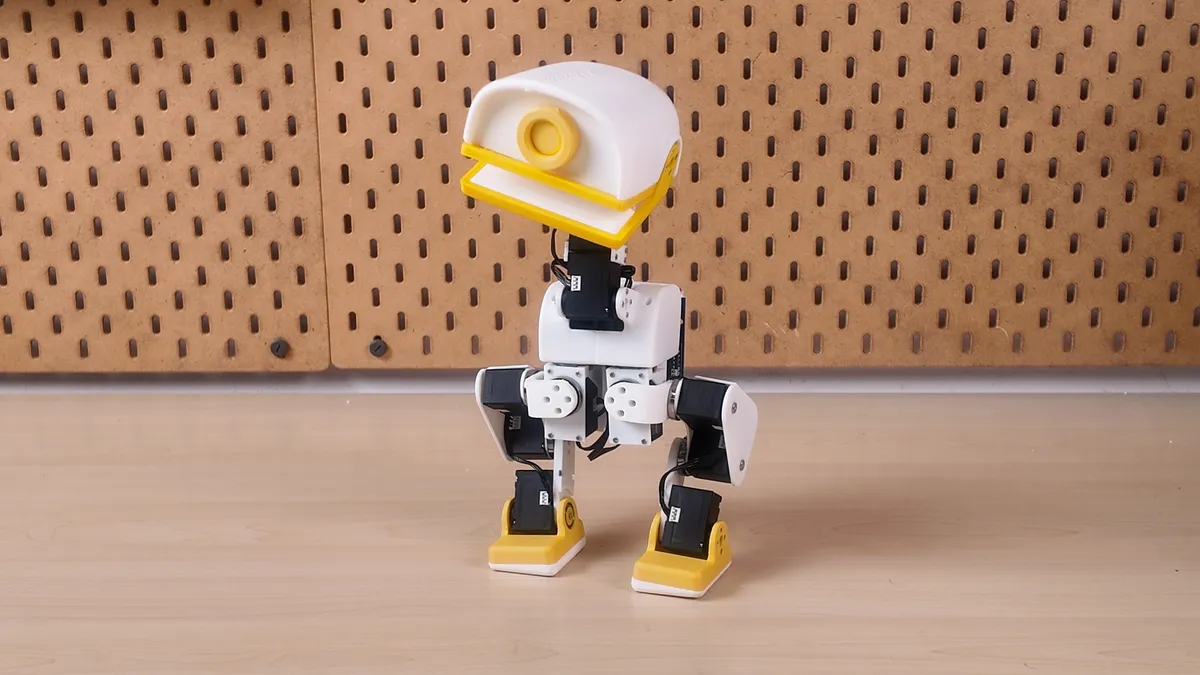
ドラゴンロボットラボでは、アヒル型の二足歩行ロボット XGO-Duck の歩行を MuJoCo・mjlab での強化学習で学習させ、実機で動かしています。この記事では、その経験をもとにフィジカルAIの基本をまとめます。
フィジカルAIとは
フィジカルAIは、センサーで状況をとらえて判断し、モーターなどを動かして現実の世界に働きかける AI のことです。ロボットのほか、自動運転車やドローンにも使われる言葉で、NVIDIA などの企業が「Physical AI」として打ち出しています。
生成AIと比べると、違いがはっきりします。
| 生成AI(チャット・画像生成) | フィジカルAI | |
|---|---|---|
| 入力 | 文章や画像 | カメラの映像、IMU(傾きと回転)、関節の角度などセンサーの値 |
| 出力 | 文章や画像 | 関節の目標角度など、モーターへの指令 |
| 時間 | 数秒かかっても使える | 1秒に数十回、遅れずに指令を出し続ける |
| 間違えたとき | 答えが不正確になる | 転ぶ、ぶつかる、壊れる |
いま注目されている理由は、主に次の3つです。
- シミュレーションが速くなった:GPU で何千台ものロボットを同時にシミュレーションし、短い時間で学習できるようになりました。
- 道具がオープンになった:物理シミュレーターの MuJoCo や、ロボット学習のフレームワークがオープンソースで公開されています。
- ロボット向けの大きなモデル:画像と指示を受け取って動作を出力するモデル(VLA:Vision-Language-Action)の研究が、多くの企業や大学で進んでいます。
ロボットが歩き方を覚える仕組み:強化学習
歩き方は、人がプログラムで一つひとつ書くのが難しい動きです。そこで、ロボットに試行錯誤させて、うまくいった動きを覚えさせる強化学習を使います。XGO-Duck の歩行を例にすると、要素は次の4つです。
- 観測:ロボットの状態です。たとえば IMU で測った体の傾きと回転の速さ、各関節の角度と速さ、直前に出した指令、「前へ進む」「曲がる」といった操作の指令です。
- 行動:歩行ポリシー(ニューラルネットワーク)が出す、関節の目標角度です。XGO-Duck では脚と首・頭の14関節を動かし、口のサーボは別に制御します。
- 報酬:動きの良し悪しを点数にしたものです。指令どおりの向きと速さで進めたら加点、倒れたら大きく減点、ガクガクした動きや無駄な力にも減点、のように設計します。
- 学習:PPO などのアルゴリズムで、報酬の合計が大きくなるようにポリシーを少しずつ更新します。
学習はシミュレーションの中で行います。はじめのうちロボットはすぐに倒れますが、たくさんのロボットが同時に試行錯誤を重ねるうちに、立つ、バランスを取る、足を出す、という動きを身につけていきます。同じだけの試行錯誤を実機だけで行うのは、時間の面でも故障の面でも現実的ではありません。
当ラボでは、物理シミュレーターの MuJoCo と、GPU で動く MuJoCo Warp の上に Isaac Lab と同じ形の API を載せたフレームワーク mjlab を使っています。
シミュレーションと実機の差(sim-to-real)
シミュレーションで歩けても、そのまま実機に移すと転ぶことがよくあります。原因は、シミュレーターの中のロボットと本物のロボットの小さな違いです。
- サーボ:指令から動き出すまでの遅れ、摩擦、ギアのがたつき
- 機体:部品の重さや重心の誤差、配線の張り
- センサーと通信:IMU のノイズ、データが届くまでの遅れ
- 床:机、フローリング、カーペットで滑りやすさが違う
この差を埋める主な方法は次のとおりです。
- サーボをモデル化する:実物のサーボを動かして特性を測り、シミュレーターのモデルに反映します。Rhoban の BAM(Better Actuator Models)は、振り子の試験台で記録した動きからサーボの摩擦モデルを求め、MuJoCo などで使えるようにするオープンソースのライブラリです。
- ドメインランダム化:重さや摩擦、遅れなどを学習のたびにわざとばらつかせ、多少の違いでは転ばないポリシーにします。
- 遅れとノイズを入れて学習する:センサーの値にノイズを加えたり、指令が遅れて届く状況も学習させたりします。
- 実機では段階的に試す:はじめは体を支えながら短い時間だけ動かし、いつでも止められるようにしてから、少しずつ自由に歩かせます。
二足歩行は、この差がはっきり表れる課題です。小さなロボットなら、シミュレーションと実機の違いを自分の目で確かめながら、対策を一つずつ試せます。
机の上で試せる二足歩行ロボット
XGO-Duck
XGO-Duck は、Pollen Robotics の Microduck をもとに Luwu Dynamics が開発したアヒル型の二足歩行ロボットです。
| 部分 | 内容 |
|---|---|
| 関節 | Feetech 1910 シリアルサーボ15個(脚10、首と頭4、口1) |
| コントローラー | Arduino UNO Q。Linux 側で歩行ポリシーを推論し、マイコン(STM32)側でサーボとセンサーと通信 |
| 姿勢センサー | 6軸 IMU(QMI8658A) |
| 機体 | 3Dプリント部品。壊れても印刷し直せる |
学習した歩行ポリシーを書き出し、ロボットのボードの上で動かすところまで一台で試せます。組み立ては組み立て記録と手順動画、サーボの準備はID 設定とキャリブレーションで紹介しています。
Microduck
Microduck は Pollen Robotics の組み立て済みロボットで、SDK、シミュレーター、強化学習の学習環境が Apache-2.0 で公開されています。日本からの予約方法や届く時期は「Microduck は日本で買える?」にまとめました。
フィジカルAIの始め方
1. まずシミュレーションで
MuJoCo は無料のオープンソースで、Windows・macOS・Linux で動きます。歩行ポリシーを学習させるなら GPU があると速く、mjlab での学習には NVIDIA の GPU が必要です(macOS は学習済みポリシーの評価のみ)。手元に GPU がなければ、クラウドの GPU を借りる方法もあります。
2. 次に実機で
シミュレーションで歩くようになったら、実機に移します。XGO-Duck は部品キット(79,800円・税込)から組み立てるか、組み立て・校正済みの XGO-Duck(119,800円・税込)を選べます。法人・学校向けは1台 99,800円(税抜・税込 109,780円)です。どちらも秋葉原駅から徒歩10分以内の神田で受け取れます。
3. 研修やサポートを使う
企業の技術研修や大学・高専の授業には、XGO-Duck を教材に、シミュレーションでの強化学習から実機で動かすまでをオンラインで学ぶフィジカルAI研修があります。研究・開発で小型ロボットの強化学習に取り組む方には、学習環境づくりから実機へのデプロイまでの強化学習サポートもご用意しています。
よくある質問
フィジカルAIと生成AIの違いは何ですか?
生成AIは文章や画像を出力しますが、フィジカルAIはセンサーの値を受け取り、モーターへの指令を出力して現実の世界で体を動かします。1秒に数十回、遅れずに判断し続ける必要があり、間違えると転倒や衝突につながる点も違います。
強化学習を試すのにどんなパソコンが必要ですか?
MuJoCo は Windows・macOS・Linux で動きます。歩行ポリシーを学習させるなら GPU のあるパソコンが向いていて、mjlab での学習には NVIDIA の GPU が必要です。GPU がない場合は、クラウドの GPU を使う方法もあります。
実機がなくても学べますか?
学べます。強化学習の考え方、報酬の設計、学習と評価は、シミュレーションだけで一通り試せます。当ラボのフィジカルAI研修も、シミュレーションだけの内容にできます。
なぜ二足歩行ロボットで学ぶのですか?
歩行はシミュレーションと実機の差がはっきり表れる課題なので、sim-to-real の難しさと対策を実感しながら学べます。机の上に置ける大きさなら、転んだときの危険や修理の負担も小さく済みます。
参考
- MuJoCo(Google DeepMind の物理シミュレーター)
- mjlab(Isaac Lab の API を MuJoCo Warp の上で使うフレームワーク)
- BAM(Better Actuator Models)(サーボの摩擦モデルを求めるライブラリ)
- Microduck 公式ストア
MuJoCo・mjlab・BAM は各プロジェクトのソフトウェア、Microduck は Pollen Robotics の製品です。ドラゴンロボットラボはこれらのプロジェクトとは関係ありません。